Reddit 评论抓取器:将 Reddit 线程导出为 CSV 或 JSON
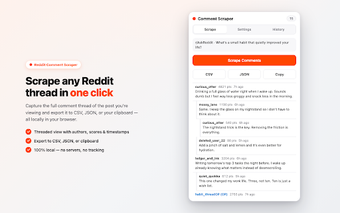
Reddit 评论抓取器 - CSV & JSON 导出,由其开发者提供,提取 Reddit 讨论供研究人员和分析师使用。它允许用户以单一操作将完整的评论树保存为结构化的 CSV 或 JSON 文件,针对定性和定量工作流程。该工具强调简单的捕获和导出,适用于需要快速访问 Reddit 对话以进行后续分析和报告的研究、新闻和营销团队。
这个抓取工具是为了收集什么而构建的,谁受益最大?
该扩展专注于从单个 Reddit 帖子中收集评论线程,适合需要对话数据进行分析的市场研究人员、数据科学家、记者和学生。它支持单线程提取,明确旨在将讨论内容移入标准分析管道。用例包括情感研究、客户反馈聚合和学术研究,在这些情况下,保持对话上下文很重要。
与云工具相比,它如何处理隐私和数据流?
该扩展完全在浏览器内部处理抓取的数据,不会将内容发送到开发者服务器,从而消除了云上传要求和外部账户。它在没有 API 密钥的情况下访问 Reddit 的公共端点,并避免与开发者绑定的远程存储。这样的设计将数据保留在用户的机器上,并减少了在提取步骤中对第三方基础设施的依赖。
对于非程序员来说,它是否易于使用,并且对于研究工作流程是否可重复?
基于弹出窗口的无代码界面让用户选择要包含的字段,并从本地历史中重新打开过去的会话,使得迭代工作变得更容易,而无需编写脚本。用户可以选择元数据,例如作者、分数、时间戳和正文文本。该扩展在导出的文件中保留回复嵌套,因此线程结构和元数据在电子表格和程序分析中均可用。
它如何扩展,用户应该预期什么实际限制?
批量导出可以将多个打开的 Reddit 标签页中的评论合并到一个文件中,这加快了批量收集的速度,但将处理负载转移到浏览器。由于所有处理都在本地运行,资源需求取决于打开的标签页数量和线程大小;非常大的批次可能会减慢浏览器。该扩展适用于 Chrome 和其他基于 Chromium 的浏览器,因此在专用配置文件上进行测试有助于在大规模导出期间管理资源。
一个专注于本地、可重复的 Reddit 数据收集的工具
这个扩展是研究人员和分析师的实用选择,他们需要直接访问 Reddit 对话而无需外部账户。预期会有一个权衡:本地处理将计算放在您的浏览器上,因此请计划适度批量的收集。提示:使用专用的浏览器配置文件,并将生成的 CSV 或 JSON 导入您喜欢的分析环境,以保持工作流程整洁和可重复。